Arthur Zinck
Spécialiste Kubernetes · en production depuis 2016 · Rakuten, Enedis, Bedrock Streaming
Spécialiste Kubernetes : je diagnostique avant d'intervenir
En bref. La plupart des clusters Kubernetes coûtent trop cher et tombent pour des raisons prévisibles. Un spécialiste Kubernetes digne de ce nom commence par mesurer, pas par vendre. Voici comment je travaille, ce que j'inspecte, et pourquoi ça change tout.
Estimez ce que votre cluster gaspille
Trois chiffres que vous trouvez dans votre facture et dans Grafana. Les valeurs par défaut sont celles du cluster réel montré plus bas. Le calcul suppose que la ressource la plus utilisée dicte le dimensionnement : le reste de la capacité est payé sans être consommé.
Capacité payée et non consommée
1 100 € / mois
Soit 13 200 € par an, sur une facture de 2 500 € par mois.
Estimation indicative. Une partie de cet écart est une marge de sécurité légitime : personne ne vise 100 % d'utilisation. L'objectif d'un audit est de séparer la marge utile du gaspillage.
Kubernetes coûte cher quand personne ne regarde vraiment
Les clusters sur-provisionnés, c'est la règle, pas l'exception.
Le rapport 2026 State of Kubernetes Resource Optimization situe l'utilisation CPU moyenne des clusters à 8 % et la mémoire à 20 %. Le reste est alloué, facturé, inutilisé.
Le sous-titre du rapport dit le plus important : and getting worse. Ces chiffres se dégradent d'une édition à l'autre. Autrement dit, ce n'est pas un retard que le marché est en train de rattraper.
Ce n'est pas une question de mauvaise volonté, c'est structurel. Les équipes provisionnent large pour éviter les incidents. Les requests et limits sont copiées d'un projet à l'autre sans être revisitées. Les namespaces s'accumulent. Les nœuds inactifs restent allumés parce que personne n'a le temps de regarder.
Résultat : des incidents que personne ne sait expliquer, des alertes qui se déclenchent sans raison apparente, et une facture qui grimpe chaque mois sans que la charge réelle ait bougé.
Un cluster Kubernetes mal configuré ne coûte pas un peu plus cher. Il coûte deux à dix fois plus cher que nécessaire.
C'est le problème qu'un spécialiste Kubernetes est censé résoudre. Pas en appliquant des recettes génériques : en regardant ce qui se passe réellement dans votre cluster. J'ai détaillé ma méthode de réduction de facture dans cet article.
Ce qu'un spécialiste regarde et qu'un généraliste ne voit pas
Un consultant généraliste va vérifier que les pods tournent, que les déploiements passent, que les services répondent. C'est nécessaire. C'est insuffisant.
Le dimensionnement des nœuds. Est-ce que le type d'instance correspond aux profils de charge réels ? Un cluster de m5.4xlarge pour des workloads à faible CPU et forte mémoire, c'est de l'argent jeté.
Les requests et les limits. Trop basses, elles déclenchent des OOMKills. Trop hautes, elles gaspillent de la capacité. L'équilibre ne se trouve pas sans mesure. Deux règles suffisent pour l'essentiel.
HPA et VPA. L'autoscaling horizontal et vertical ne s'excluent pas, mais ils ne se combinent pas n'importe comment. Mal configurés, ils se contredisent.
Les network policies. Leur absence donne un cluster plat où n'importe quel pod parle à n'importe quel autre. Personne ne le sait jusqu'au jour où ça pose un problème.
Les storage classes. Choisir gp2 là où gp3 suffit, ou du RWX là où du RWO ferait l'affaire : ça se voit sur la facture.
L'observabilité. Sans métriques correctement configurées, sans logs structurés, sans tracing, on navigue à vue. Et on le découvre pendant un incident.
Ce qu'un généraliste ne voit pas, ce sont les interactions entre ces couches. Un OOMKill peut venir d'une request mal calibrée, d'une fuite mémoire applicative, ou d'un voisin bruyant sur le nœud. Distinguer les trois demande de l'expérience et des données.
Ma méthode : mesurer d'abord, recommander ensuite
Je ne vends pas de travail avant d'avoir posé un diagnostic. Ce n'est pas une posture, c'est une contrainte opérationnelle : recommander une migration ou une refonte sans avoir regardé les données, c'est du conseil à l'aveugle.
L'audit : ce que j'inspecte
L'utilisation réelle des ressources. CPU, mémoire, réseau, stockage, par nœud, par namespace, par workload. Je compare ce qui est alloué à ce qui est consommé.
La configuration des workloads. Requests et limits, stratégies de déploiement, sondes, affinités et anti-affinités.
L'autoscaling. HPA, VPA, Cluster Autoscaler : est-ce qu'ils sont configurés, et est-ce qu'ils font ce qu'on croit ?
Le réseau et le stockage. Network policies, ingress, service mesh s'il y en a un. Storage classes, PVC orphelins, snapshots jamais nettoyés.
La sécurité de base et l'observabilité. RBAC, pod security standards, secrets exposés. Couverture des métriques, qualité des alertes, dashboards réellement utilisables.
J'instrumente ce qui manque, et je collecte sur une période représentative, pas sur un instantané.
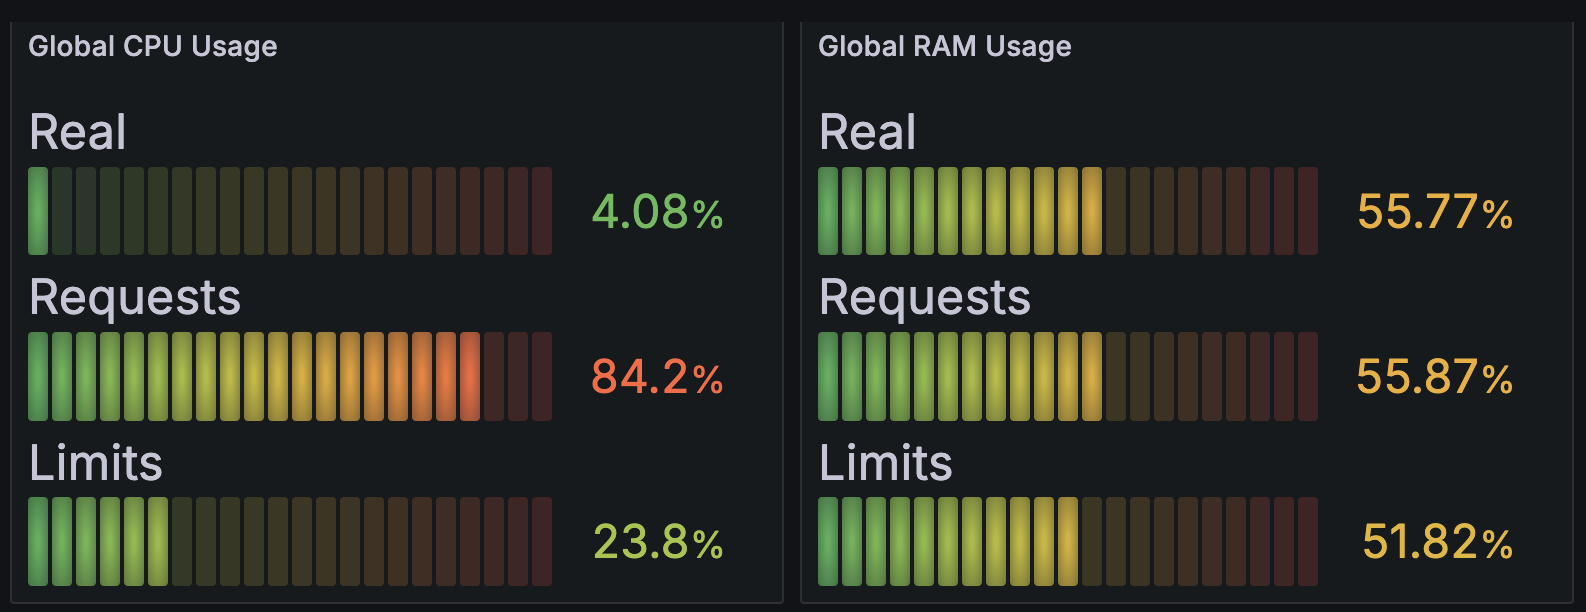
C'est exactement le genre d'écart que l'audit cherche, et ce graphe montre pourquoi il faut regarder les deux ressources séparément.
Le CPU sur-réservé ne se voit pas dans les performances : les applications tournent bien. Il se voit au scheduler. Avec 84 % de la capacité réservée, le cluster se déclare presque plein et refuse de placer de nouveaux pods, alors que les machines tournent à 4 %. L'équipe ajoute des nœuds pour un cluster qui ne fait rien.
La mémoire, elle, n'a rien à corriger ici. Et c'est important : elle devient la vraie contrainte de dimensionnement. On ne peut pas réduire le parc en dessous de ce que la mémoire exige, même avec un CPU à 4 %. Un consultant qui promettrait 96 % d'économie sur ce cluster raconterait n'importe quoi.
Le rapport : ce que vous recevez
Pas une liste de bonnes pratiques génériques. Les problèmes identifiés, classés par impact sur le coût, la fiabilité et la sécurité. Les données qui les étayent : graphes, métriques, logs, pas des affirmations. Une estimation chiffrée du gain ou du risque évité pour chaque point. Et des recommandations priorisées, avec ce que je ferais en premier et ce que je laisserais pour plus tard.
Vous pouvez prendre ce rapport et le faire implémenter par votre équipe. C'est prévu, et c'est même souhaitable si vous en avez les moyens.
L'intervention : seulement si elle se justifie
Si le diagnostic révèle des problèmes que je peux résoudre, je propose une intervention. Si le cluster est sain et que les optimisations restantes ne justifient pas le coût d'une mission, je le dis. Je ne crée pas de travail pour justifier une présence.
Ce que je prends en charge
L'audit Kubernetes. Inspection complète du cluster, rapport de diagnostic avec les données.
L'optimisation des coûts. Dimensionnement des nœuds et des workloads, nettoyage des ressources inutilisées, configuration de l'autoscaling.
La fiabilité et la résilience. PodDisruptionBudgets, stratégies de déploiement, montées de version, tests de charge. Le détail est dans les bonnes pratiques de résilience.
Les post-mortems d'incidents. Analyse des causes racines avec les données, et ce qu'il faut changer pour éviter la récurrence.
Ce que je ne fais pas : du développement applicatif, de l'exploitation quotidienne, du support 24/7. Je suis un spécialiste, pas un infogéreur.
Pourquoi Kubernetes déraille, et comment je le détecte
Des OOMKills en cascade. Un pod sans limite mémoire peut consommer tout le nœud et provoquer l'éviction des autres. Un pod avec une limite trop basse se fait tuer dès qu'il la dépasse, même si le nœud a de la mémoire libre. Je le détecte avec container_oom_events_total et l'historique des évictions.
Des coupures pendant les montées de version. Sans PodDisruptionBudget, un drain de nœud peut évacuer plusieurs répliques du même déploiement en même temps. Le service tombe, l'équipe cherche un bug applicatif, et c'est une configuration manquante. Ça se lit dans les événements Kubernetes.
Un voisin bruyant sur le stockage. Deux workloads sur le même nœud qui partagent un disque. L'un génère beaucoup d'I/O, l'autre ralentit, les sondes échouent, le pod redémarre. La cause est la contention, pas l'application. Visible dans les latences disque par nœud.
Un Cluster Autoscaler qui ne scale pas. Il ajoute des nœuds quand des pods sont en Pending. Mais si ces pods ont des affinités trop restrictives, des taints sans toleration, ou des requests supérieures à la taille des nœuds disponibles, ils restent Pending et rien ne se passe. Ça se voit dans les événements de scheduling et les logs de l'autoscaler.
Un cas particulier que je rencontre souvent sur la JVM : un démarrage lent pris pour une panne. J'en ai fait un article dédié.
La courbe d'un de ces OOMKills, et la façon de l'interpréter, sont plus bas dans les questions qu'on me pose.
Trois questions qu'on me pose souvent
Quelle est la mauvaise configuration Kubernetes la plus fréquente chez vos clients ?
Je retrouve toujours les quatre mêmes. Des images Docker mal construites. Des requests et des limits absentes : dans la majorité des cas, personne n'a mis de valeur, et quand il y en a une, elle date du premier jour. Des probes de healthcheck qui ne vérifient rien de réel quand elles existent, et très souvent il n'y en a simplement pas. Et des HPA mal configurés, qui scalent au mauvais moment ou pas du tout.
Les deux absences se paient au même endroit. Sans requests, le scheduler place à l'aveugle : il ne sait pas ce qu'un pod consomme, donc il entasse jusqu'à ce que le nœud sature. Sans probe, Kubernetes ne sait pas qu'une application est morte et continue de lui envoyer du trafic.
Aucune des quatre n'est difficile à corriger. C'est exactement pour ça qu'elles durent : aucune ne fait assez mal un jour donné pour remonter en haut de la pile, et elles coûtent tous les mois.
Comment distinguer en pratique un problème de limite de ressources d'une fuite mémoire applicative ?
Un seul OOMKill ne prouve rien. Je commence par la courbe, parce que sa forme désigne la cause presque à tous les coups. Un pic isolé, c'est un batch qui a saturé la mémoire au passage. Une marche qui ne redescend plus, c'est une version plus gourmande déployée la veille. Une pente régulière, c'est une fuite.
Quand le doute persiste, je déploie le service dans un environnement isolé, sans trafic, et je regarde. Sur un cas que j'ai traité, la mémoire montait quand même : 1,5 Mio par heure pendant 21 heures, jusqu'à l'OOMKill. Le pod neuf repartait à 14 Mio et fuyait déjà. Sans trafic, les faux positifs habituels sont écartés : il ne reste qu'une vraie fuite, une goroutine qui ne meurt jamais, un ticker qui accumule, un handle jamais fermé.
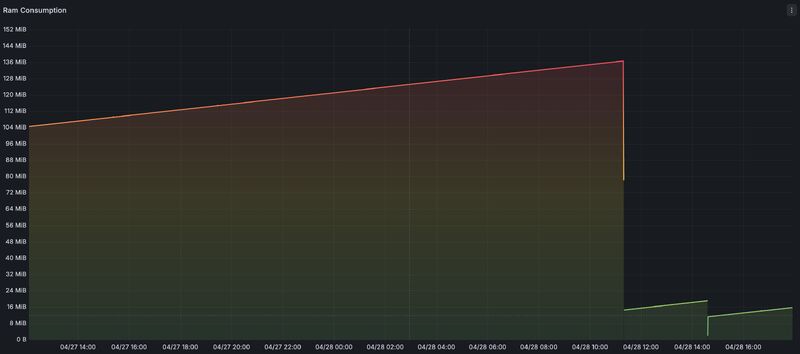
Le piège, c'est que Kubernetes redémarre le pod tout seul. Le dashboard reste vert, le pod est healthy, et la fuite peut durer des mois sans que personne la voie passer. Le redémarrage automatique est pratique, mais il masque le problème au lieu de le corriger.
Quel est le cas d'optimisation le plus surprenant que vous ayez traité ?
Un projet où tout fonctionnait et où personne ne supportait plus la lenteur. Des timeouts, des connexions perdues, des symptômes partout et aucune explication. L'équipe cherchait depuis un moment, sans rien trouver d'anormal.
C'était Traefik, le point d'entrée du cluster. Son CPU était throttlé à plus de 90 %. Tout ce qui entrait attendait derrière lui, donc tout le cluster paraissait lent, y compris des services qui allaient parfaitement bien.
Le piège, c'est que les graphes ne montraient rien. L'utilisation CPU de Traefik n'approchait jamais sa limite. Le throttling ne se lit pas sur cette courbe : le quota est appliqué par tranches de 100 millisecondes, donc un pod peut être étranglé en permanence tout en affichant une moyenne basse. Il faut regarder container_cpu_cfs_throttled_seconds_total, qui n'est sur aucun dashboard par défaut.
L'équipe ne surveillait pas cette métrique, et ce n'est pas un reproche. La régulation du CPU par le CFS du noyau Linux n'est pas un concept Kubernetes, c'est une couche en dessous. On peut opérer un cluster pendant des années sans jamais croiser ce mécanisme, jusqu'au jour où il décide de vos performances. C'est précisément le genre d'angle mort qu'un regard extérieur sert à combler.
Recalibrer les ressources d'un seul pod a changé les performances perçues de tout le cluster. C'est le cas qui illustre le mieux pourquoi je commence par mesurer : la cause n'était ni dans les applications qui ralentissaient, ni sur la courbe que tout le monde regardait. Le throttling invisible et le dimensionnement des ressources, j'en ai fait un article.
Questions fréquentes
Qu'est-ce qu'un spécialiste Kubernetes ?
Un expert technique focalisé sur l'architecture, la configuration, l'optimisation et la fiabilité des clusters. Contrairement à un généraliste cloud, il connaît les interactions entre les couches (scheduler, kubelet, CNI, CSI, control plane) et sait diagnostiquer ce qui n'est pas visible en surface. Il ne se contente pas de déployer des workloads : il comprend pourquoi un cluster se comporte mal et comment le corriger durablement.
Combien coûte un audit Kubernetes ?
Cela dépend de la taille du cluster, du nombre de workloads et de la complexité de l'environnement. Sur un cluster de taille moyenne, une dizaine à une trentaine de nœuds et quelques dizaines de services, comptez 3 à 5 jours. Le prix est fixe et arrêté après un premier échange de 30 minutes : pas de régie ouverte, pas de surprise.
Kubernetes managé ou spécialiste externe ?
Les offres managées gèrent le control plane. Elles ne configurent pas vos workloads, ne calibrent pas vos requests, ne définissent pas vos network policies et ne vous disent pas pourquoi votre facture a doublé. Un spécialiste externe intervient précisément sur ce que le fournisseur ne touche pas. Les deux sont complémentaires.
Combien de temps dure un audit ?
Entre 3 et 7 jours ouvrés selon la complexité. Une partie de ce temps sert à collecter des données sur une période représentative, idéalement une semaine de trafic réel. Un rapport rendu en 24 h sur la base d'un instantané ne vaut rien.
On regarde votre cluster ?
Un cluster qui coûte trop cher, qui tombe pour des raisons floues, ou que vous n'arrivez pas à faire évoluer sans risque. Premier échange de 30 minutes, sans engagement.
Décrire ma situation